Jak roboty uczą się chodzić i utrzymywać równowagę?
Zdolność maszyn do dwunożnej lokomocji przeszła w ostatnich latach rewolucję, porzucając sztywne algorytmy na rzecz adaptacyjnego uczenia maszynowego. Zastanawiając się, jak roboty uczą się chodzić i utrzymywać równowagę w nieprzewidywalnym świecie, musimy spojrzeć na skomplikowaną architekturę sieci neuronowych oraz zaawansowaną inżynierię mechatroniczną. Jako inżynier i audytor systemów zrobotyzowanych zapraszam na głęboką analizę mechanizmów, które sprawiają, że współczesne humanoidy przestają przypominać ociężałe maszyny z filmów science-fiction, a zaczynają naśladować płynną motorykę człowieka.
Dlaczego klasyczne modele fizyczne ustępują algorytmom Reinforcement Learning?
Przez dekady inżynierowie programowali ruch maszyn za pomocą ręcznie pisanych modeli matematycznych i sztywnych skryptów. Klasyczne podejście opierało się na technologii Model Predictive Control (MPC), która z ogromną dokładnością obliczała trajektorię każdego stawu na podstawie z góry zdefiniowanej fizyki. O ile to rozwiązanie doskonale sprawdzało się na płaskich i laboratoryjnych podłożach, o tyle całkowicie zawodziło w terenie, gdzie robot potykał się o nieznane wcześniej przeszkody.
Współczesna branża robotyki dokonuje radykalnej zmiany paradygmatu, stawiając na end-to-end Reinforcement Learning (RL), czyli uczenie przez wzmocnienie. Jak wskazują analizy publikowane przez ekspertów [Źródło 1], robot nie otrzymuje już dokładnej instrukcji kroku, lecz system cyfrowych „nagród” za postępy w przemieszczaniu się i „kar” za upadek na ziemię. Maszyna uczy się na własnych błędach, zupełnie jak ludzkie niemowlę stawiające pierwsze kroki. Niemniej jednak, najdoskonalsze komercyjne platformy utrzymują architekturę hybrydową. Producent kultowych „psów-robotów” potwierdza, że łączy rygorystyczne bezpieczeństwo MPC z elastycznością modułów RL, które aktywują się na wyjątkowo śliskich nawierzchniach [Źródło 2].
W jaki sposób roboty pokonują „Lukę Rzeczywistości” (Reality Gap)?
Największym inżynieryjnym wyzwaniem podczas trenowania lokomocji jest tak zwana Luka Rzeczywistości, czyli drastyczna różnica między sterylnym środowiskiem cyfrowym a fizycznym światem pełnym niedoskonałości. Robot, który wykonuje perfekcyjne salta w kodzie programu, często przewraca się po pierwszym kroku na prawdziwym dywanie z powodu mikrosekundowych opóźnień na łączach silników czy minimalnie odmiennego współczynnika tarcia podłoża.
Rozwiązaniem tego problemu, stanowiącym pilnie strzeżony standard branżowy, jest Domain Randomization (losowość domenowa). Inżynierowie celowo „psują” środowisko wirtualne podczas treningu. Algorytmy bez przerwy i losowo modyfikują parametry fizyczne całego świata: zwiększają grawitację o 5%, obniżają wagę wirtualnych ramion robota, smarują wirtualne podłoże cyfrowym lodem i symulują gwałtowne podmuchy wiatru [Źródło 3]. Zmusza to politykę sterowania (policy) do wypracowania potężnie zdywersyfikowanych i odpornych wzorców ruchu, które poradzą sobie z każdą anomalią w rzeczywistości.
Symulatory GPU: Wirtualna szkoła przetrwania dla algorytmów
Trening zaawansowanego humanoida o wadze 50 kilogramów w fizycznym świecie jest nieefektywny, niebezpieczny dla personelu i grozi destrukcją niezwykle kosztownego prototypu. Maszyny trenuje się więc w oparciu o ideę Sim-to-Real w zaawansowanych środowiskach, takich jak Isaac Gym (Isaac Lab) czy MuJoCo. Oprogramowanie to przetwarza fizykę bezpośrednio na kartach graficznych (GPU), umożliwiając generowanie doświadczeń dziesiątek tysięcy wirtualnych robotów jednocześnie. Kilka godzin symulacji odpowiada dekadom fizycznego czołgania się i chodzenia.
Świętym Graalem tej technologii jest Zero-shot Transfer. Sytuacja ta ma miejsce, gdy głęboka sieć neuronowa wytrenowana wyłącznie na serwerach wirtualnych zostaje wgrywana do fizycznego „mózgu” robota i działa bezbłędnie za pierwszym uruchomieniem, nie wymagając strojenia kalibracyjnego w laboratoriach [Źródło 4].
Jak szybko reaguje „mózg” robota na poślizgnięcie? Anatomia pętli kontrolnej
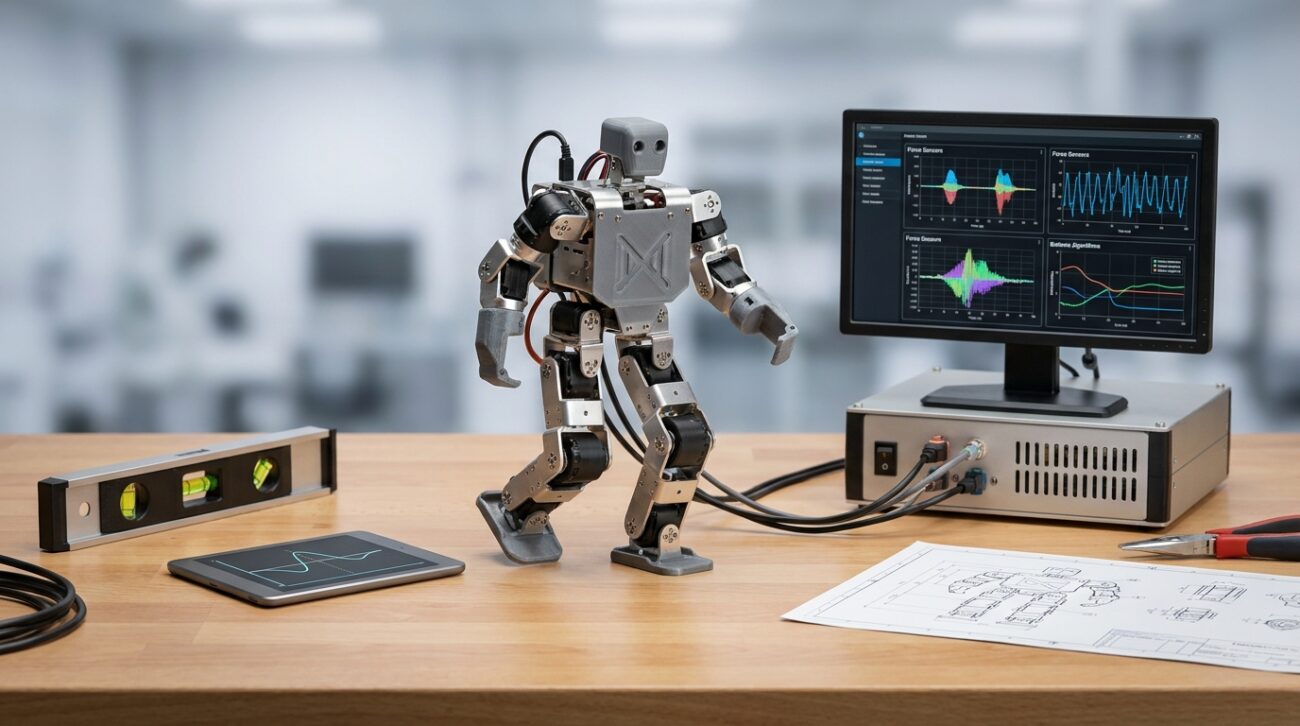
Aby robot utrzymał pion przy nagłym popchnięciu, czas reakcji jego układu decyzyjnego musi zamykać się w rygorystycznym okienku około 5 milisekund, co daje częstotliwość sterowania na poziomie 200 Hz. Odczyt danych środowiskowych, przetworzenie sygnałów i decyzja o wysterowaniu momentu obrotowego na silniki odbywa się niemal z prędkością ludzkiego odruchu rdzeniowego.
Decyzje te nie są podejmowane w chmurze internetowej, lecz opierają się o zjawisko Embodied Intelligence (wcielonej inteligencji). Oznacza to, że maszyna radzi sobie z grawitacją dzięki ultra-szybkiej pętli lokalnej łączącej hardware z AI [Źródło 5]. Centralnym narządem zmysłu jest tu IMU (Inertial Measurement Unit), technologiczny odpowiednik błędnika w uchu środkowym człowieka, składający się z zaawansowanych akcelerometrów i żyroskopów.
Czytaj więcejZwiń
| Parametr Balansu | Układ Biologiczny (Człowiek) | Układ Zrobotyzowany (Humanoid) |
|---|---|---|
| Główny narząd równowagi | Błędnik, wzrok, propriocepcja | Moduł IMU, kamery głębi, enkodery optyczne |
| Czas reakcji na potknięcie | Około 100 – 150 milisekund | Zaledwie 5 milisekund (200 Hz) |
| Złożoność motoryczna | Ponad 360 stawów i mięśni szkieletowych | Od 27 do ponad 40 stopni swobody (DoF) |
| Złożoność obliczeniowa | Biologiczne sieci neuronowe układu nerwowego | Rozwiązanie 10 000 zmiennych w 1 ms |
Czego nie przeczytasz w generycznych poradnikach: Retargetowanie kinematyczne
Kluczem do stworzenia humanoida naśladującego płynność ludzkiego ruchu jest proces nazywany w inżynierii retargetowaniem kinematycznym. Kiedy twórcy maszyn pobierają nagrania z systemów Motion Capture na aktorach, nie mogą ich bezpośrednio skopiować na hardware. Wynika to z faktu, że roboty i ludzie różnią się radykalnie w kwestii długości poszczególnych „kości” i rozmieszczenia środka ciężkości. Sieć neuronowa musi zatem przetłumaczyć topologię ludzkiego chodu na specyficzne, 21-osiowe wymogi geometryczne robota w czasie rzeczywistym, maskując nienaturalne przeskoki serwomotorów.
Jakie prędkości osiągają najszybsze dwunogi i czworonogi na świecie?
Połączenie wydajnych silników siłowników z rewolucyjnymi algorytmami wywindowało parametry lokomocji współczesnych robotów na poziomy zarezerwowane dotąd dla sportowców wyczynowych. Algorytmy klasy aktor-krytyk, na czele ze słynnym PPO (Proximal Policy Optimization), stały się obecnie najstabilniejszym oprogramowaniem do generowania szybkich cykli chodzenia.
Flota komercyjnych czworonogów Spot, testowana bezustannie w przemyśle chemicznym, elektrowniach i kopalniach, przeszła po trudnych szlakach ponad 250 000 kilometrów, dostarczając inżynierom terabajty danych sensorycznych [Źródło 2]. Skutkiem tego treningu jest zdolność czworonoga do biegu z prędkością 11,5 mph (ponad 18,7 km/h). Z kolei świat humanoidów zdominował pełnowymiarowy model Unitree H1 (1,8m / 47 kg), który za sprawą dynamicznej równowagi osiągnął zatwierdzony rekord biegu dla dwunogów na poziomie 3,3 m/s (około 11,8 km/h).
Z perspektywy inżyniera: Brutalna rzeczywistość testowania hardware’u
W mojej codziennej audytorskiej i inżynieryjnej praktyce często zauważam, że teoretyczny zachwyt nad potęgą sztucznej inteligencji szybko zderza się z bolesnymi ograniczeniami sprzętowymi. Obserwowanie testów w halach produkcyjnych drastycznie rewiduje wyobrażenia opierające się wyłącznie na zgrabnie zmontowanych filmach promocyjnych.
Wprowadzanie polityk AI typu „end-to-end” na fizyczne prototypy bardzo często kończy się widowiskowymi, wielotysięcznymi stratami w ułamku sekundy. Algorytm z symulatora często podejmuje z matematycznego punktu widzenia genialną decyzję, aby utrzymać równowagę. Niestety, w prawdziwym życiu fizyczne obciążenie prądowe na układzie sterującym może sprawić, że siłownik po prostu się zapali, zanim „wyratuje” upadającą, stutrzydziestofuntową maszynę. W fizyce materiałowej, w przeciwieństwie do kodu Pythona, nie ma skrótów.
Nietypowe ujęcie problemu: Koncepcja Extreme Humanoid Balance (HuB)
Najbardziej wyrafinowane ośrodki badawcze odchodzą od stabilnego, zachowawczego chodu, eksplorując ramy tak zwanego Extreme Humanoid Balance, badane między innymi przez konsorcja Tsinghua i UC Berkeley [Źródło 3]. Celem tych frameworków badawczych (np. projektu HuB) jest doprowadzenie do perfekcji ruchów niestandardowych – takich jak długotrwałe balansowanie całym ciężarem ciała na jednej nodze, asymetryczne kucnięcia (deep squats) pod ciężarem zewnętrznym lub precyzyjne oddawanie dynamicznych kopnięć w przestrzeń. Zdolności te definiują przeskok technologiczny maszyn od etapu zwykłej maszynowej sztywności do pełnej, humanoidalnej gimnastyki.
To właśnie ta niezauważalna orkiestracja – od ułamków sekund decyzyjności w procesorach, po precyzyjne odczyty z IMU na każdym mikropęknięciu podłoża – sprawia, że sztuczna inteligencja napędza współczesną robotykę kroczącą ku nowej dekadzie innowacji.
Bibliografia i źródła
- [Źródło 1] Zestawienie rewolucji AI w nauce o systemach kognitywnych (naukawpolsce.pl)
- [Źródło 2] Boston Dynamics Technical Blog & Reports (bostondynamics.com)
- [Źródło 3] Otwarte repozytorium prac naukowych i frameworku HuB (arxiv.org)
- [Źródło 4] Figure AI Engineering Case Studies (figureai.pl)
- [Źródło 5] Publikacje dotyczące wcielonej inteligencji (forumakademickie.pl)
FAQ – najczęściej zadawane pytania
Czym różni się uczenie przez wzmocnienie od klasycznych modeli fizycznych w robotyce?
Klasyczne modele opierają się na sztywnych obliczeniach matematycznych, które sprawdzają się głównie w laboratorium. Uczenie przez wzmocnienie (Reinforcement Learning) pozwala robotom uczyć się na własnych błędach poprzez system nagród i kar, co zapewnia lepszą adaptację do trudnego terenu.
W jaki sposób roboty radzą sobie z tzw. „Luką Rzeczywistości”?
Inżynierowie stosują losowość domenową (Domain Randomization), celowo modyfikując parametry fizyczne w symulacji, takie jak tarcie czy grawitacja. Dzięki temu algorytm wypracowuje odporne wzorce ruchu, które działają w nieprzewidywalnym świecie rzeczywistym.
Jaką funkcję pełnią symulatory GPU w procesie uczenia maszyn?
Symulatory GPU umożliwiają równoległy trening dziesiątek tysięcy wirtualnych robotów jednocześnie. Kilka godzin takich obliczeń odpowiada dekadom fizycznych prób, co pozwala na osiągnięcie etapu Zero-shot Transfer, czyli działania robota bez kalibracji po wgraniu kodu.
Jak szybko reaguje robot na nagłe zachwianie równowagi?
Układ decyzyjny robota musi zareagować w ciągu około 5 milisekund (częstotliwość 200 Hz). System wykorzystuje moduł IMU, działający jak ludzki błędnik, oraz tzw. wcieloną inteligencję, która przetwarza sygnały sensoryczne z prędkością zbliżoną do odruchu rdzeniowego.
Czym jest retargetowanie kinematyczne w kontekście robotyki?
To proces dostosowywania nagranego ruchu człowieka do specyficznej budowy robota. Ponieważ maszyny różnią się od ludzi długością kończyn i rozkładem masy, sieć neuronowa musi w czasie rzeczywistym przeliczać te parametry, aby ruch pozostał płynny i stabilny.
Jakie rekordy prędkości osiągają współczesne roboty kroczące?
Czworonożny robot Spot potrafi poruszać się z prędkością do 18,7 km/h. Wśród humanoidów wyróżnia się model Unitree H1, który dzięki zaawansowanej równowadze dynamicznej osiągnął prędkość około 11,8 km/h.