Czy robot może nauczyć się nowego zadania, obserwując człowieka?
Roboty z sukcesem opanowują zupełnie nowe zadania wyłącznie poprzez wzrokową i sensoryczną obserwację ludzkich demonstracji. Ten gigantyczny skok technologiczny, napędzany przez zaawansowane modele behawioralne, na zawsze eliminuje potrzebę żmudnego, ręcznego programowania każdego ruchu maszyny.
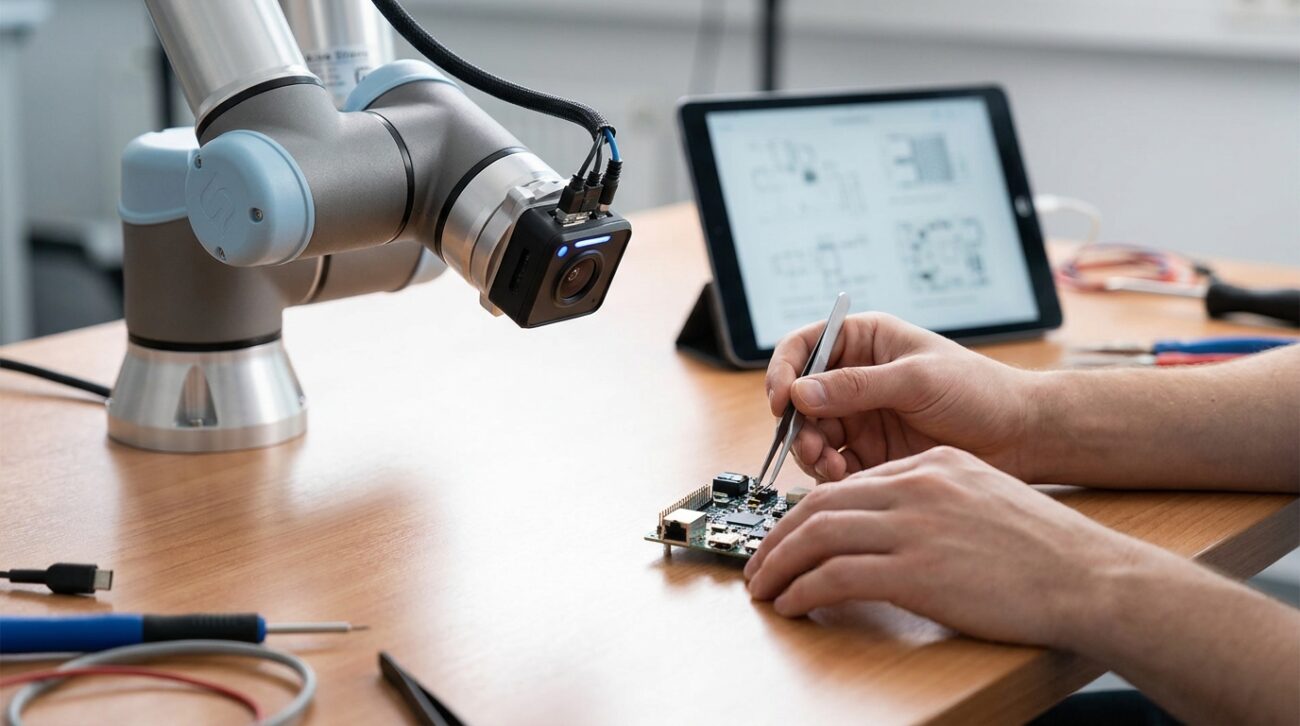
W tradycyjnej inżynierii programowanie ramienia robotycznego do tak prostej czynności jak podniesienie szklanki wymagało dziesiątek tysięcy linii kodu. Dzisiejsze podejście, znane jako Uczenie z demonstracji (LfD – Learning from Demonstration) lub naśladownictwo (Imitation Learning), opiera się na zupełnie innym paradygmacie. Maszyna przetwarza surowy obraz z kamer na matematyczną mapę akcji, co potwierdzają najnowsze badania publikowane m.in. przez [Źródło 1]. Skuteczność tych systemów sprawia, że sztuczna inteligencja zyskała ciało – potrafi nie tylko „myśleć”, ale i wchodzić w fizyczną interakcję z otoczeniem.
Od kodu do naśladowania: Duże Modele Zachowań (LBM)
Duże Modele Zachowań (LBM – Large Behavior Models) stanowią odpowiednik popularnych modeli językowych (LLM), jednak zamiast generować kolejne słowa, przewidują optymalne ruchy w świecie fizycznym. Analizując dane z czujników dotyku i kamer, systemy te kalkulują kąty wychylenia siłowników i siłę chwytu. Co ważne, wstępnie wytrenowane LBMs wymagają o 80% mniejszej ilości danych demonstracyjnych do opanowania nowej umiejętności manualnej w porównaniu do klasycznych algorytmów, co dowodzą przełomowe projekty wdrażane przez Toyota Research Institute [Źródło 2].
W mojej codziennej praktyce inżynieryjnej przy wdrażaniu systemów automatyki często spotykam się z błędnym założeniem, że to algorytm decyzyjny stanowi wąskie gardło AI. Zauważyłem jednak, że najczęstszym błędem jest ignorowanie fizycznych opóźnień samej mechaniki (latencji sprzętowej) – robot „wie” jak zareagować po mikrosekundzie od zaobserwowania upadającego przedmiotu, ale ograniczenia prądowe serwomotorów nie pozwalają mu na wykonanie tej akcji na czas.
Czego nie dowiesz się ze zwykłych poradników: XIRL i problem „Cross-Embodiment”
Prawdziwym wyzwaniem dla sztucznej inteligencji nie jest skopiowanie ruchu, lecz przełożenie go na zupełnie inną fizjonomię maszyny za pomocą metody XIRL. Cross-Embodiment Inverse Reinforcement Learning (XIRL) to samo-nadzorowana technika, dzięki której robot nie próbuje ślepo kopiować pięciopalczastej dłoni człowieka przy pomocy swojego dwupalczastego chwytaka. Zamiast tego wnioskuje o nadrzędnym celu zadania (np. „otwórz słoik”) i realizuje go własną mechaniką, co szeroko opisano w literaturze branżowej [Źródło 3].
Aby testować skuteczność takich algorytmów u robotów o skrajnie różnej budowie anatomicznej, inżynierowie z firm technologicznych stworzyli wirtualne środowisko X-MAGICAL. To symulowany benchmark, w którym ocenia się, czy agent posiadający np. formę koła zrozumie intencję agenta posiadającego formę kwadratu. Zdolność abstrahowania celu od sposobu jego wykonania to esencja współczesnej zrobotyzowanej inteligencji.
Polityka Dyfuzyjna a praca z delikatnymi materiałami
Zastosowanie modeli dyfuzyjnych, dotychczas kojarzonych z generowaniem obrazów w Midjourney, zrewolucjonizowało płynność i delikatność ruchów maszyn (tzw. Diffusion Policy). Rozbicie złożonych zachowań ciągłych na miniaturowe sekwencje działań pozwoliło robotom z powodzeniem operować delikatnymi obiektami, takimi jak surowe jajka, bez ich rozgniatania [Źródło 4].
W przeszłości dominowało klasyczne Behavioral Cloning (BC), polegające na dosłownym mapowaniu stanu sensorycznego na akcję robota. Metoda ta zawodziła, gdy maszyna napotykała bodźce nieco odbiegające od danych treningowych (tzw. problem przesunięcia dystrybucji). Jak wskazują najnowsze dane opublikowane przez [Źródło 5], zastosowanie zaawansowanych procesów Gaussa przy przewidywaniu właściwości fizycznych nieznanych, miękkich obiektów sprawiło, że błąd pozycjonowania chwytaka spadł aż o 74%.
Czytaj więcejZwiń
| Kryterium porównawcze | Klasyczne Programowanie | Polityka Dyfuzyjna & LfD |
|---|---|---|
| Sposób nauki | Tysiące linii kodu (C++/Python) | Analiza wideo i danych telemetrycznych |
| Elastyczność zadań | Bardzo niska (wąska specjalizacja) | Wysoka (wnioskowanie o celu XIRL) |
| Skuteczność z nowym obiektem | Wymaga kalibracji inżyniera | Błąd chwytania zredukowany o 74% |
One-Shot Learning: Skuteczność poparta twardymi danymi
Algorytmy typu „One-Shot” potrafią nauczyć robota całego procesu po obejrzeniu zaledwie jednego, kilkusekundowego materiału demonstracyjnego. Najnowocześniejsze modele fizyczne, takie jak GEN-1.5, wykazują skuteczność rzędu 59% na bazie 3 do 12 sekund nagrania z człowiekiem, o czym informują twórcy oprogramowania [Źródło 6].
Prawdziwa magia dzieje się przy minimalnym zwiększeniu puli danych. Gdy algorytm otrzyma 5 minut nagrań (co odpowiada zaledwie około 50 powtórzeniom danej czynności) i przejdzie przez 10 szybkich kroków optymalizacji gradientowej, jego celność drastycznie szybuje do poziomu 83%.
- Brak nowego kodu: Inżynierowie bez użycia klawiatury przekazali maszynom ponad 60 codziennych czynności.
- Błyskawiczna adaptacja: Skuteczność One-Shot Learning na poziomie od 59% do 83%.
- Oszczędność danych: Spadek zapotrzebowania na objętość setów treningowych o ponad 80%.
Nietypowe ujęcie problemu: MANO, zręczność i platforma UMI
Kluczem do naśladowania precyzyjnej ludzkiej motoryki przez maszyny są algorytmy wizyjne, w tym model MANO, który buduje kinetyczną siatkę z nagrań 2D. Hand Model (MANO) bezbłędnie przekłada zwykły, płaski obraz pikseli dłoni z amatorskiego filmu wideo na trójwymiarową konstrukcję uwzględniającą aż 21 specyficznych punktów przegubowych [Źródło 7]. Dzięki temu maszyna nie tylko wie, gdzie dłoń się znajduje, ale dokładnie rozumie orientację każdego stawu podczas chwytania długopisu czy narzędzia.
Problem zbierania tychże danych w środowisku naturalnym rozwiązała platforma Universal Manipulation Interface (UMI) opracowana w porozumieniu z kluczowymi amerykańskimi uczelniami [Źródło 8]. UMI to przełomowo tania metoda, pozwalająca zwykłym ludziom rejestrować zadania domowe wprost z perspektywy pierwszej osoby (za pomocą kamer sportowych i prostych mechanicznych chwytaków), zasilając tym samym bezpośrednie repozytoria uczenia maszynowego.
Cyfrowa wyobraźnia i uczenie się mimiki (Robot EMO)
Nowoczesne roboty uczą się modelu własnego ciała we wbudowanej „cyfrowej wyobraźni”, co pozwala im na niemal bezbłędną lokalizację w przestrzeni. Poprzez zaledwie 3-godzinną obserwację własnych ruchów w zasięgu kamer, ramię robotyczne tworzy trójwymiarową chmurę punktów. Jak relacjonuje [Źródło 9], ta wewnętrzna mapa kinematyczna pokrywa się z jego fizycznymi ograniczeniami z dokładnością przekraczającą 99%.
„Uczenie się poprzez sprzężenie zwrotne w lustrze to przełom na drodze do maszyn w pełni samoświadomych przestrzenie – redukuje margines błędu wyobraźni przestrzennej poniżej jednego procenta”.
Równie fascynująca jest ewolucja robotów w sferze interakcji społecznych, czego wybitnym dowodem jest humanoidalny robot EMO. Maszyna nie opanowała naturalnej mimiki poprzez bezpośrednie dyrektywy programistyczne, lecz samodzielnie analizując korelację między komendami wysyłanymi do swoich 26 siłowników twarzy a obrazem odbitym w zwykłym lustrze, jak udokumentowano na łamach [Źródło 10] oraz [Źródło 11]. Dodatkowe godziny przetwarzania materiałów wideo z ludzkimi emocjami z platform społecznościowych pozwoliły jej asymilować ludzkie uśmiechy czy wyrazy zdziwienia z ułamkiem sekundy wyprzedzenia w stosunku do rozmówcy.
Podsumowując, mariaż generatywnej sztucznej inteligencji, modeli LBM i platform takich jak UMI ostatecznie odpowiedział twierdząco na pytanie, czy maszyna potrafi uczyć się ze wzroku. Przyszłość robotyki przestała zależeć od szybkości pisania kodu w laboratoriach, a zaczęła od objętości i jakości dostarczonych demonstracji.
Bibliografia i źródła
- [Źródło 1] Imitation Learning Concepts (scholarpedia.org)
- [Źródło 2] 60 skills learned without code (triglobal.pl)
- [Źródło 3] Diffusion Policies in Modern Robotics (therobotreport.com)
- [Źródło 4] Research on Diffusion Policy variants (arxiv.org)
- [Źródło 5] Gaussian processes for extrapolation errors (arxiv.org)
- [Źródło 6] GEN-1.5 Model Statistics (generalistai.com)
- [Źródło 7] 21-joint MANO hand model translation (arxiv.org)
- [Źródło 8] Universal Manipulation Interface Platform (mit.edu)
- [Źródło 9] Cyfrowa wyobraźnia u robotów przemysłowych (focus.pl)
- [Źródło 10] EMO Robot i nauka mimiki twarzy (naukawpolsce.pl)
- [Źródło 11] Humanoidalne systemy siłowników (interia.pl)
- [Źródło 12] Advancements in Data Labeling (macgence.com)
- [Źródło 13] AI Training Frameworks (imeritai.pl)
- [Źródło 14] Future of Robotics Tech (freethink.com)
- [Źródło 15] Automation Standards (bvhkomde.pl)
- [Źródło 16] Technical Machine Learning Insights (medium.com)
- [Źródło 17] Technologie przyszłości – raport rynkowy (rp.pl)
- [Źródło 18] Rozwój automatyki domowej (mediaexpert.pl)
- [Źródło 19] Large Behavior Models (therobotreport.com)
- [Źródło 20] Cross-Embodiment Training (therobotreport.com)
- [Źródło 21] Hardware constraints in AI algorithms (therobotreport.com)
FAQ – najczęściej zadawane pytania
W jaki sposób współczesne roboty uczą się nowych zadań od ludzi?
Roboty wykorzystują metodę uczenia z demonstracji (LfD), która polega na analizie obrazu z kamer i danych sensorycznych zamiast ręcznego programowania każdego ruchu.
Czym są Duże Modele Zachowań (LBM)?
LBM to odpowiedniki modeli językowych, które przewidują ruchy w świecie fizycznym i pozwalają na naukę umiejętności manualnych przy użyciu o 80% mniejszej ilości danych.
Na czym polega technika XIRL w kontekście naśladowania ruchu?
Technika XIRL pozwala robotowi zrozumieć nadrzędny cel zadania i zrealizować go za pomocą własnej mechaniki, unikając ślepego kopiowania ruchów ludzkiej dłoni.
Jakie są zalety zastosowania polityki dyfuzyjnej (Diffusion Policy)?
Pozwala ona na uzyskanie wyjątkowej płynności ruchów, dzięki czemu roboty mogą bezpiecznie operować bardzo delikatnymi materiałami, takimi jak surowe jajka.
Jak skuteczna jest metoda One-Shot Learning w nauce maszyn?
Modele te wykazują skuteczność na poziomie 59% przy nagraniu trwającym do 12 sekund, a po 5 minutach demonstracji celność wzrasta do 83%.
Jak robot EMO nauczył się reagować mimiką twarzy?
Robot samodzielnie analizował korelację między swoimi siłownikami a odbiciem w lustrze oraz przetwarzał nagrania wideo z ludzkimi emocjami, co pozwoliło mu na asymilację uśmiechu czy zdziwienia.